Mostrando entradas con la etiqueta backups. Mostrar todas las entradas

jueves, 30 de diciembre de 2010

Introducción a DataProtector


DataProtector es el software de HP destinado a la realización de copias de seguridad automatizadas y recuperación de servidores y de entornos empresariales. Existen versiones para Windows y UNIX/Linux, así como soporte tanto para sistemas de almacenamiento en cinta como en disco. Dispone de módulos específicos para Oracle, SQL Server, SAP, Exchange, etc. La versión con la que vamos a trabajar en este artículo es la 6.10.


Creación de nuevos pools
Un pool es un conjunto lógico (o grupo) de medios con uso común. Sólo se puede tener medios del mismo tipo físico en ese pool, aunque no importa su localización (p.ej. el slot o drive dentro robot de cintas). Varios dispositivos pueden hacer uso de un mismo pool.
Para la creación de un nuevo pool accederemos a la opción "Devices & Media" de DataProtector. Desplegaremos "Environment" à "Media" y pulsaremos con el botón secundario del ratón sobre "Pools". En el menú contextual que nos aparecerá, seleccionamos la opción "Add Media Pool" que nos abrirá un asistente que nos guiará en el proceso:


El primer paso consistirá en dar un nombre a nuestro nuevo pool y especificar el tipo de medio que será utilizado. En este ejempo vamos a crear un pool de cintas LTO, por lo que seleccionaremos "LTO-Ultrium":


Una vez hecho esto, en el siguiente paso, especificaremos la política de adicción de datos durante el proceso de realización copia. Este concepto tiene que ver con la eficiencia y maximización del espacio utilizado de los medios. Podremos seleccionar el modo en como DataProtector trata el espacio sobrante en el medio de la copia de seguridad anterior.
Las políticas de uso del medio pueden ser "Appendable", "Non Appendable" y "Appendable on Incrementals Only":
  • Con la política "Appendable", una sesión de backup comienza a escribir datos en el espacio que queda en el medio utilizado por la última sesión de esa copia de seguridad. Si fuesen necesarios más medios en esta sesión, se escribirían desde el comienzo de la cinta, por lo que sólo cintas nuevas o desprotegidas pueden utilizarse.
  • Con la política "Non Appendable", una sesión de backup comienza a escribir datos al comienzo del primer medio disponible para el backup. Cada medio contiene datos de una única sesión.
  • Con la política "Appendable of Incrementals Only", una sesión de backup añade datos al medio sólo si se está realizando un backup incremental. Estos nos permitirá disponer de un conjunto completo de copias de seguridad (full e incrementales), si hay espacio suficiente.


Por otra parte puede interesar indicar el uso del pool libre "Free LTO Ultrium", de forma que si no hay espacio en las cintas de este nuevo pool que estamos creando, también se pueda hacer uso de las cintas del "free pool":


En la siguiente y última pantalla no podemos hacer nada, simplemente se nos informa de la validez del pool (36 meses o 250 escrituras):


Debemos recordar este dato, pues cuando se lleguen a cualquiera de estos dos factores nuestras cintas serán marcadas como "poor quality".
Cintas marcadas con calidad pobre (en rojo)


Y al pulsar en "Finish", habremos creado el pool que podremos utilizar a posteriori al definir nuestras especificaciones de backups.

NOTA: Existen diversos problemas que pueden provocar que nuestras cintas se marquen con el flag "poor quality", no sólo el uso o el tiempo de vida de la propia cinta (p.ej. un fallo de conectividad que provoque el corte de conexión con el cliente, o bugs propios de DataProtector por lo que necesitaremos tener actualizado DP mediante los parches que podemos descargarnos de la página de HP).
Para resetear el flag de la cinta, accederemos por consola a la ruta de instalación de "Omniback", y dentro de éste directorio, al subdirectorio "bin" (por defecto C:\Archivos de Programa\Omniback\bin), y ejecutaremos el comando:

omnimm -reset_poor_medium Medium_ID

donde Medium_ID lo podemos obtener de la información de la propia cinta (en el GUI de DP, "Devices & Media", buscamos la cinta, pulsamos sobre ella con el botón secundario y seleccionamos "Properties", y en la ventana emergente vamos a la pestaña "Info"):


Otros comandos de consola interesantes son (para conocer por qué una cinta puede estar marcada en rojo):
  • Parches instalados en DP: omnicheck -patches -host <nombre_host>
  • Report de una sesión: omnidb -session <SessionId> -report 


Creación de nuevas "Especificaciones de backups"
Para crear una nueva definición de backups, una vez ubicados en esta opción, pulsaremos con el botón secundario del ratón sobre el tipo de especificación que deseeamos crear (Filesystem, MSExchange Single Mailboxes, MSExchange Server, MS SQL Server, etc.) y seleccionaremos la opción "Add Backup".


El siguiente paso es seleccionar la plantilla que queremos utilizar, lo normal es que hagamos uso de una plantilla en blanco. Como vemos existen diferentes tipos de plantillas dependiendo de la especificación que vayamos a utilizar.


Plantillas Filesystem


Plantillas MS Exchange Single Mailbox


Plantillas MS Exchange Server

Plantillas MS SQL Server


El siguiente paso consistirá en seleccionar los diferentes elementos o clientes que formarán parte del backup (sobre los que se realizará el respaldo):

Elementos seleccionables en una especificación FileSystem


Una vez seleccionado qué datos queremos respaldar, el siguiente paso es seleccionar dónde queremos hacerlo. Nos aparecerá en la siguiente ventana la posibilidad de seleccionar los dispositivos o discos que emplearemos a la hora de realizar el backup.


No sólo debemos seleccionar el dispositivo o disco, sino también el pool que emplearemos para ello. Si pulsamos con el botón secundario del ratón sobre el dispositivo seleccionado, aparecerá un menú contextual en el que seleccionaremos la opción "Properties":


Y en ella podremos seleccionar el "pool":


Una vez seleccionado el dónde, en el siguiente paso podremos especificar una serie de opciones sobre la realización de la copia de seguridad, como si queremos ejecutar algún comando antes o después de realizar el backup, definir el propietario, el grupo al que pertenece o el tiempo de protección de los ficheros:


Posiblemente la opción que más nos interese es el periodo de protección de los ficheros respaldados, la cual podemos definir en la opción "Filesystem Options" pulsando en el botón "Advanced":


Deberemos analizar cuánto tiempo deseamos proteger los archivos, teniendo en cuenta si se trata de una copia externalizada o si permanecerá en el robot, el tamaño de la copia de seguridad con relación al número de cintas por pool/tamaño de las mismas, etc.

Y como último paso de este proceso de especificación, deberemos planificar el calendario de realización de las copias de seguridad:


Para ello, en la parte inferior pulsaremos en el botón "Add":


Definiendo una serie de variables como la recurrencia (diaria, semanal, mensual), la hora de realización, el tipo de copia (full, incremental) o la protección del backup:


Las dos opciones más interesantes serán la "recurrencia" semanal y el tipo de backup a realizar:


Una vez añadidas todas las programaciones que deseemos, se nos mostrará una última pantalla de resumen, en la que podremos revisar toda la especificación de backup creada.


martes, 18 de mayo de 2010

Backups y restauraciones en SQL Server (V): Mover los ficheros de datos


En este artículo vamos a ver cómo podemos mover los ficheros de nuestras bases de datos en SQL Server de un servidor o instancia de SQL a otro/a. Vamos a ver en primer lugar la forma "clásica" (clasificada como deprecated por Microsoft) que es mediante sp_detach_db/sp_attach_db (para SQL Server 2000), y la forma recomendada en la actualidad (SQL Server 2005/2008) mediante ALTER DATABASE … MODIFY FILE.
Los datos y archivos de registro de transacciones de una base de datos pueden separarse y adjuntarse a la misma instancia de SQL Server (o a otra). Esto nos será útil si queremos cambiar la BB.DD. a otra instancia o mover sus ficheros de ubicación. La condición "sine qua non" es que nuestros SQL Server sean de la misma versión con el mismo juego de caracteres, el mismo criterio de ordenación y misma intercalación UNICODE.
Para realizar esta opción podemos utilizar el procedimiento almacenado de sistema sp_attach_db para adjuntar el fichero de la base de datos a nuestro SQL Server, de la siguiente forma:
EXEC sp_attach_db @dbname = N'BBDD',
@filename1 = N'Unidad:\ruta\BBDD_Data.mdf',
@filename2 = N'Unidad:\ruta\BBDD_log.ldf'
donde:
  • @dbname es el nombre que le daremos a la base de datos.
  • @filename1 es la ruta física de disco del fichero de la base de datos a adjuntar.
  • @filename2 es la ruta física de disco del fichero de log de la base de datos.


Previamente deberemos "separar" los ficheros de la base de datos haciendo uso del procedimiento almacenado sp_detach_db, para lo cual se requiere que tengamos acceso exclusivo a la misma:
USE master;
--ponemos la BB.DD. en modo exclusivo
ALTER DATABASE BBDD SET single_user;
GO
--separamos el fichero de la BB.DD.
EXEC sp_detach_db @dbname = N'BBDD';
Al separar una base de datos, la estemos eliminando de la instancia de SQL Server, pero quedan intactos sus archivos de datos y de registro de transacciones. Estos archivos pueden utilizarse después para adjuntar la base de datos a cualquier instancia de SQL Server, incluyendo el servidor del que se separó.
No podremos separar una base de datos si se cumple cualquiera de las condiciones siguientes:
  • La base de datos está replicada y publicada. Si está replicada, la base de datos no debe estar publicada. Antes de separarla, debemos deshabilitar la publicación ejecutando sp_replicationdboption. Este procedimiento crea o quita tablas específicas del sistema de réplica, cuentas de seguridad, etc., según las opciones proporcionadas. Para deshabilitar la publicación, la base de datos de publicaciones debe estar conectada. Si existe una instantánea de la base de datos para la base de datos de publicaciones, se debe quitar la instantánea antes de deshabilitar la publicación. Las instantáneas de base de datos son copias de sólo lectura y sin conexión de bases de datos, y no están relacionadas con una instantánea de réplica.
          sp_replicationdboption @dbname= 'BBDD' @optname='publish' @value='false'


Si tenemos algún problema al ejecutar este procedimiento almacenado, podemos realizar el proceso de forma manual siguiendo los pasos que se detallan en http://support.microsoft.com/kb/324401 .
  • Existe una instantánea de base de datos en la base de datos (sólo versiones 2005 y 2008). Para poder separar la base de datos, debemos quitar todas sus instantáneas, haciendo uso del comando DROP DATABASE NombreInstantanea . Para identificar la instantánea que queremos eliminar, nos conectaremos mediante el Explorador de Objetos a la instancia de SQL Server, expandiremos Base de datos y a continuación haremos lo propio con Instantáneas de base de datos.

     
  • Se está creando un reflejo de la base de datos. La base de datos no se puede separar hasta que finalice la sesión de creación de reflejo de la base de datos. Para ello utilizaremos la sentencia ALTER DATABASE BBDD PARTNER OFF.
  • La base de datos es sospechosa. Debemos poner la base de datos sospechosa en modo de emergencia antes de separarla haciendo uso de la sentencia ALTER DATABASE db_state_option=' EMERGENCY' .
  • La base de datos es una base de datos del sistema.


Como hemos indicado al inicio, estos dos procedimientos almacenados (sp_detach_db y sp_attach_db) han sido etiquetados como obsoletos en las versiones SQL Server 2005 y 2008 por lo que ya no se recomienda su uso. En su lugar, el método apropiado para reubicar ficheros en estas últimas versiones es con ALTER DATABASE … MODIFY FILE. Ejecutaremos este comando para cada fichero que queramos mover y conmutaremos el estado de la base de datos a online/offline.
ALTER DATABASE BBDD SET OFFLINE;
ALTER DATABASE BBDD
    MODIFY FILE (
        NAME='BBDD_Log',
        FILENAME='Unidad:\ruta\BBDD_Log.ldf');
ALTER DATABASE BBDD SET ONLINE;

jueves, 29 de abril de 2010

Backups y restauraciones en SQL Server (IV): Restauración de una BBDD


Vamos a ver cómo recuperar una base de datos concreta, en el caso de realizar la recuperación en un servidor de destino diferente del origen. Voy a utilizar una base de datos denominada WSS_Content.

En primer lugar vamos a realizar una copia de seguridad completa de la BBDD. Para ello abriremos el analizador de consultas (en este ejemplo utilizo un SQL Server 2000 aunque sería lo mismo pero a través del Management Studio de SQL Server 2005/8) y nos conectaremos al servidor origen. Lanzamos el backup completo:
BACKUP DATABASE WSS_Content TO DISK = 'E:\bk_WSS_Content.bk' WITH INIT


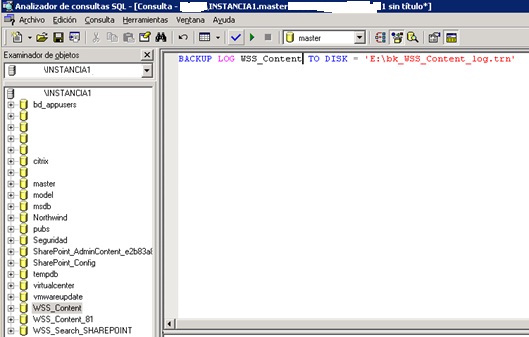
Y a continuación haremos lo propio con el registro de transacciones:
BACKUP LOG WSS_Content TO DISK = 'E:\bk_WSS_Content_log.trn'


Para realizar la restauración deberemos tener en cuenta que la ubicación de la base de datos, al tratarse de otro servidor, puede ser diferente. Para ello haremos uso de la opción MOVE que nos servirá para indicar la ubicación tanto del fichero de datos como del registro de transacciones. Para conocer la ubicación en disco exacta pulsaremos con el botón secundario del ratón sobre la BBDD sobre la que vayamos a realizar la restauración, y seleccionamos "Propiedades". En las pestañas "Archivo de datos" y "Registro de transacciones" de la ventana que se abre, podremos conocer la ubicación de estos dos ficheros:


Vamos a partir del supuesto que la base de datos ya existe en el servidor destino. En caso negativo, deberemos crear la base de datos (simplemente crearemos una BB.DD. nueva, con el mismo nombre). Empezamos el proceso de restauración propiamente dicho.

En primer lugar deberemos poner nuestra base de datos en modo monousuario o exclusivo, para lo cual nos conectaremos al servidor destino mediante el analizador de consultas de SQL Server y ejecutaremos la sentencia:
ALTER DATABASE WSS_Content SET Single_User;
Podemos "expulsar" a los usuarios inmediatamente o tras un determinado tiempo haciendo de la opción ROLLBACK, para lo cual añadiremos a la sentencia anterior WITH
ROLLBACK AFTER segundos o WITH ROLLBACK IMMEDIATE.


Y una vez realizado este paso, podemos comenzar el proceso de restauración. En primer lugar hacemos uso del Full Backup:
RESTORE DATABASE WSS_Content FROM DISK = 'E:\backupsProduccion\bk_WSS_Content.bak' WITH MOVE 'WSS_Content' TO 'E:\Archivos de Programa\Microsoft SQL Server\MSSQL\Data\WSS_Content_Data.mdf', MOVE 'WSS_Content_log' TO 'E:\Archivos de Programa\Microsoft SQL Server\MSSQL\Data\WSS_Content_log.ldf', NORECOVERY


Indicando la opción NORECOVERY. En el caso de que tuviésemos incrementales, deberíamos ir haciendo restauraciones sucesivas de cada uno de estos backups.
A continuación, restauramos el registro de transacciones:
RESTORE LOG WSS_Content FROM DISK = 'E:\backupsProduccion\bk_WSS_Content_log.trn' WITH RECOVERY

O si queremos hacer una restauración hasta un punto concreto en el tiempo podemos hacer uso de la opción STOPAT:
RESTORE LOG WSS_Content FROM DISK = 'E:\backupsProduccion\bk_WSS_Content_log.trn' WITH STOPAT = N'4/28/2010 11:01:45 PM', RECOVERY


Una vez finalizado el proceso de restauración, ponemos la BBDD en modo multiusuario:
ALTER DATABASE WSS_Content SET Multi_User;


jueves, 15 de abril de 2010

Backups y restauraciones en SQL Server (III): T-SQL básico para la realización de backups


Vamos a ver en este artículo algo de transact SQL para la realización de los distintos tipos de backups.


Backups completos.    

Es necesario establecer un punto de referencia inicial, independientemente del modo de recuperación que vayamos a emplear. Para ello, crearemos un backup completo de nuestra BB.DD. La cláusula en T-SQL es:
BACKUP DATABASE Nombre_BBDD TO DISK = 'Unidad:\ruta\ficherobackup.bak' WITH INIT
Con el parámetro WITH INIT nos aseguraremos de que el fichero de backup contiene una única copia de seguridad ya que, por defecto, el comando BACKUP lo añade al fichero existente. De esta forma nos aseguramos que el fichero se sobreescribe.
En los modos Full-Recovery o Bulk-Logged Recovery, los backups de los logs son esenciales, no sólo por el propósito de recuperación, sino también para controlar el tamaño del registro de transacciones activo. El modo de recuperación simple es el único que elimina las transacciones periódicamente.
Si nunca se realiza un respaldo, el registro de transacciones de una BBDD en modo Full-Recovery o Bulk-Logged Recovery continuará creciendo hasta consumir todo el espacio disponible en disco. Y si el disco se queda sin espacio, la BB.DD. se parará.
El comando para realizar el backup del fichero de log es:
BACKUP LOG Nombre_Log_BBDD TO DISK = 'Unidad:\ruta\ficherobackup.trn'
Cada acción contra la BB.DD. se asigna a un Log Sequence Number (LSN). Para restaurar a un punto específico en el tiempo, debemos tener un continuo registro de LSNs.


Backups diferenciales.
La restauración de los bakups de transacciones tiende a ser una operación lenta, especialmente si nuestro backup completo es semanal, o incluso superior en su programación en el tiempo. Los backups diferenciales intentan decrementar el tiempo de recuperación. La cláusula T-SQL es:
BACKUP DATABASE Nombre_BBDD TO DISK = 'Unidad:\ruta\ficherobackup.dif' WITH DIFFERENTIAL, INIT
El backup "ficherobackup.dif" contiene todos los cambios realizados desde el último backup completo. Podemos utilizarlo durante el proceso de restauración en combinación a los backups del registro de transacciones. En primer lugar, restaurando el backup completo, seguido de la restauración del último diferencial, y a continuación restaurando cualquier log de transacciones posterior.
Consideraremos los siguientes elementos cuando hagamos uso de backups diferenciales:
  • Si no realizamos backups completos frecuentemente, los backups diferenciales crecerán significativamente en tamaño para una BB.DD. operativa. Recordemos que un backup diferencial contiene todos los cambios desde el backup completo más reciente. Cuanto mayor sea el tiempo entre backups completos, más cambios recogerán en los diferenciales.
  • Un backup diferencial está directamente ligado a un específico backup completo. La realización de un backup completo fuera del calendario habitual de backups puede hacer inservible una copia diferencial.
  • A través del examen de la frecuencia de backups diferenciales, se puede establecer un plan de copias de seguridad. Cuando la BB.DD. sufre cambios frecuentemente, los backups diferenciales pueden consumir bastante espacio. Deberemos encontrar el equilibrio entre la velocidad de recuperación necesaria con respecto al espacio disponible.

     
NOTA: no debemos confundir los backups diferenciales con los incrementales. Los diferenciales incluyen todos los datos que han cambiado desde el último backup completo. Mientras, el incremental incluye todos los datos que han cambiado desde el último diferencial o completo. SQL Server no dispone de ningún equivalente a los incrementales.


Verificación de errores.
El proceso de backup puede realizar una verificación de los datos mientras se están respaldando ya sea verificando páginas dañadas o validando por checksums.
Debemos habilitar cualquier opción que deseemos en el nivel de la base de datos. La opción "Verificación de páginas" nos permitirá descubrir e informar sobre transacciones de E/S incompletas debidas a errores de E/S de disco. Podremos elegir entre las opciones "Ninguna", "checksum" y "TornPageDetection".


La opción "TornPagesDetection" (detección de páginas dañadas) verifica simplemente cada página de datos para ver si un proceso de escritura se ha completado en su totalidad. Si encuentra una página que ha sido sólo parcialmente escrita (debido a algún tipo de fallo hardware) simplemente se marca como "dañado".
La validación por comprobación de sumas ("Checksum") es una técnica de verificación de páginas que añade un valor para cada página de datos, esencialmente identificando el tamaño exacto en bytes de cada página. El proceso de backup puede validar por checksum comparando el valor almacenado en la base de datos con el valor asociado con la página de datos escrita en disco. Sin embargo, no lo hace por defecto. Si la validación por checksums está habilitada, podemos forzar el proceso de backup para realizar está validación.
BACKUP DATABASE Nombre_BBDD TO DISK = 'unidad:\ruta\fichero.back' WITH CHECKSUM
Cuando se encuentre con un error durante la validación por checksum, SQL Server escribirá un registro a MSDB..SUSPECT_PAGE. El comportamiento por defecto es STOP_ON_ERROR, permitiendo corregir el problema y continuar, lanzando el mismo comando con la adicción de RESTART.
La otra opción de validación por checksum es CONTINUE_ON_ERROR. Cuando está habilitada, el backup simplemente escribe el error en la tabla MSDB..SUSPECT_PAGE y continua. Sin embargo, esta tabla tiene un límite de 1000 filas, y si se alcanza, el backup fallará.
El habilitar la validación por checksum obviamente tiene un impacto en el rendimiento del proceso de backup, por lo que deberemos tener un ventana suficientemente grande para realizar las copias de seguridad.
Examinaremos la tabla MSDB..SUSPECT_PAGE para buscar el enfoque adecuado para hacer frente a los errores.


Backups divididos (striped).
Algunas BB.DD.s son demasiado grandes para crear un backup completo en una única cinta LTO o en un array de discos. En estos casos, podemos hacer uso de los backup striped, también denominados multiplexados. La ventaja es que casa dispositivo utiliza la totalidad de su capacidad para crear el backup. Su desventaja es que, en caso de fallo, todas las cintas o ficheros se necesitarán para completar una restauración.
Para crear un backup striped utilizaremos:
BACKUP DATABASE Nombre_BBDD TO DISK = 'unidad1:\ruta1\fichero1.bak' , 'unidad2:\ruta2\fichero2.bak', 'unidad3:\ruta3\fichero3.bak' WITH INIT, CHECKSUM, CONTINUE_ON_ERROR
El backup será "extendido" a través de todos los ficheros indicados.


Backups en espejo (mirrored).
Los backups en espejo son una característica incorporada desde la versión 2005 de SQL Server, y que nos permite escribir el mismo fichero de backup en múltiples ubicaciones. El comando para crear un backup en espejo es
BACKUP DATABASE Nombre_BBDD TO DISK = 'unidad1:\ruta1\fichero1.bak' MIRROR TO DISK = 'unidad2:\ruta2\fichero2.bak' MIRROR TO DISK = 'unidad3:\ruta3\fichero3.bak' WITH INIT, CHECKSUM, CONTINUE_ON_ERROR
La única restricción para realizar respaldos en múltiples localizaciones es que los dispositivos utilizados deben ser idénticos. En particular, múltiples dispositivos de cinta deben ser del mismo modelo del mismo fabricante.


Backups Sólo_copia (copy_only).
Podemos utilizar backup para propósitos distintos a los de recuperación en caso de desastre. Por ejemplo, un uso típico es utilizar un backup para mover una copia de la BBDD a un entorno de desarrollo. Como ya hemos indicado, los backups diferenciales están asociados directamente a un único backup completo. Desde SQL Server 2005 existe una característica, el backup "copy-only", que no resetea la cadena de backups. Cualquier copia de seguridad realizada fuera del esquema de los backups estándar debería ser realizada como un backup "only-copy":
BACKUP DATABASE Nombre_BBDD TO DISK = 'unidad:\ruta\ficheroBackup.bk' WITH INIT, CHECKSUM, COPY_ONLY
Si existe un calendario de respaldos en SQL Server, para cada respaldo creado existe un número de secuencia o LSN. Entonces si creamos un backup completo sin hacer uso de la opción "copy-only", esa secuencia se verá afectada y tendremos problemas para recuperar un respaldo diferencial realizado posteriormente. Necesitaremos contar con el respaldo completo que se realizó en medio de la secuencia entonces no podremos recuperar la información.
Si queremos conocer el número de secuencia podemos lanzar esta query:
SELECT database_name, backup_start_date, is_copy_only, first_lsn FROM msdb..backupset WHERE database_name = ''Nombre_BBDD' ORDER BY backup_start_date DESC


lunes, 29 de marzo de 2010

Backups y restauraciones en SQL Server (II): modelos de recuperación.


En este segundo artículo vamos a ver los modelos de recuperación existentes en SQL Server y las características principales de cada uno de ellos.


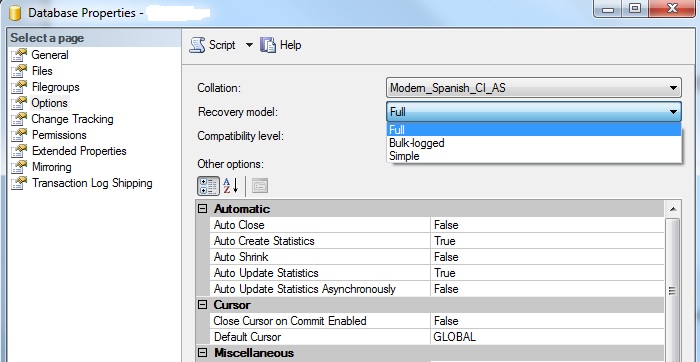
Existen tres modelos de recuperación distintos: Full Recovery, Simple Recovery y Bulk-Logged Recovery (http://msdn.microsoft.com/es-es/library/ms189275(v=sql.90).aspx ). Cada modelo determina como debería comportarse el registro de transacciones, tanto en el uso activo como durante el backup del registro de transacciones.
  • Full Recovery (recuperación completa): modelo de recuperación por defecto para una BBDD recién creada. Todo el historial de transacciones se mantiene en el registro de transacciones que deberíamos administrar. Su ventaja es que se puede restaurar hasta el momento en el que una BB.DD. falla, o hasta un punto específico en el tiempo. Su desventaja es que si lo dejamos sin administrar, el registro de transacciones puede crecer rápidamente. Si se llena el disco, lo más probable es que la BB.DD. falle. Este modo no ofrece ningún tipo de mantenimiento automatizado del registro de transacciones. La única forma de limpiar es cambiar al modo de recuperación simple o realizar una copia de seguridad del registro de transacciones.

     
  • Simple Recovery (recuperación simple): limpia el registro de transacciones activo de las transacciones realizadas durante un checkpoint. Su ventaja es que el registro de transacciones se mantiene y no necesita una administración directa. El inconveniente es que, en caso de desastre, está garantizado un cierto nivel de pérdida de datos. Es imposible restaurar el momento exacto del fallo. A pesar de que este modo de recuperación trunca el registro de transacciones periódicamente, esto no conlleva a que no crezca. Podemos fijar el tamaño del registro de transacciones a un determinado tamaño, pero si se ejecuta una inserción masiva (Bulk Insert), SQL Server lo tratará como una inserción simple. Por tanto, no sirve como respuesta para el mantenimiento de logs por lo que no deberíamos usarlo en BB.DD. en producción.

     
  • Bulk-Logged Recovery (recuperación de registros masiva): Cuando se utiliza este modelo, el registro de transacciones se comporta exactamente como si se estuviese en modo de recuperación completa, con una excepción: las operaciones masivas se registran mínimamente. Las operaciones masivas incluyen:
    • Importaciones masivas de datos, que se podrían realizar haciendo uso de BCP (Bulk Copy Program), el comando BULK INSERT u OPENWROWSET con la cláusula Bulk.
    • Operaciones LOB (Large OBject), tales como WRITETEXT o UPDATETEXT, para columnas NText o Image.
    • Cláusulas SELECT INTO.
    • CREATE INDEX, ALTER INDEX, ALTER INDEX REBUILD o DBCC REINDEX.

        Como todas estas operaciones se registran en el modelo Full Recovery, el registro de transacciones puede crecer enormemente. La ventaja del modelo Bulk-Logged Recovery es que previene de un crecimiento del registro no deseado o imprevisto. Cada vez que se realiza una operación de registro masiva, SQL Server sólo registra los identificadores de las páginas de datos que se han visto afectados. Las páginas SQL Server tienen identificadores internos, así que se puede comprimir un aumento de identificadores de páginas en una pequeña parte del registro.
    Este modelo de recuperación tiene la desventaja de que la recuperación en un punto del tiempo no es técnicamente posible. Sólo podemos restaurar al punto de la última copia de seguridad del registro de transacciones. Será posible recuperar las transacciones masivas siempre y cuando se disponga de un backup del registro de transacciones que las contiene. Por otra parte, mientras que el registro de transacciones activo en este modo es más pequeño, la copia de seguridad del log contiene copias de las páginas modificadas durante el proceso de carga masiva. El resultado son copias del registro de transacciones potencialmente grandes.
    La clave para utilizar este modelo de recuperación de forma efectiva es invocarlo sólo cuando sea necesario, y a continuación, volver al modo de recuperación completa para un punto en el tiempo del backup. Se trata de un procedimiento de riesgo, y para mover entre Bulk-Logged Recovery y Full Recovery, siempre debemos seguir los siguientes pasos:
  1. Cambiar de Full Recovery a Bulk-Logged Recovery.
  2. Realizar la operación de registro masivo.
  3. Una vez completado, volver inmediatamente al modo Full Recovery.
  4. Realizar un backup completo de la BB.DD.

En el próximo artículo veremos algo de transact SQL…

miércoles, 17 de marzo de 2010

Backups y restauraciones en SQL Server (I): Almacenamiento en disco


Vamos a comenzar una serie de artículos destinados a comprender los entresijos básicos de SQL Server. Considero que es crítico comprender cómo almacena SQL Server los datos y los escribe en disco, para comprender los requisitos de cualquier técnica de backup de SQL Server. Tipos de archivo utilizados:
  • Ficheros de datos primarios: cada BB.DD. tiene un único fichero de datos primario con la extensión por defecto .MDF. El fichero de datos primario es el único que tiene no sólo la información contenida en la BB.DD. sino también la información sobre la propia BB.DD. Cuando la BB.DD. es creada la ubicación de cada archivo se almacena en la BB.DD. master, pero también se incluye en el fichero de datos primario.
  • Fichero de datos secundarios: una BB.DD. también puede tener uno o varios ficheros de datos secundarios que tienen por defecto la extensión .NDF. Generalmente se utilizan para crear espacio de almacenamiento en unidades de disco distintas a la del fichero de datos primario, o para mantener el tamaño de cada fichero de datos individual en un tamaño máximo práctico, por lo general, por cuestiones de portabilidad.
  • Registro de transacciones: una BB.DD. debe tener al menos un fichero de registro de transacciones con una extensión por defecto .LDF. El registro o log es imprescindible pues sin un registro de transacciones accesible, no se podría realizar ningún cambio en la BB.DD. Para la mayoría de las BB.DD. en producción es crítico un sistema de copia de seguridad adecuado para el registro de transacciones. Cuando se realiza un cambio en la BB.DD. se hace en el contexto de una transacción: una o más unidades de trabajo que deben tener éxito o fallar en su conjunto.
Cuando se realiza un cambio en la BB.DD. los datos no se escriben directamente en los archivos de datos. En su lugar, el servidor de BB.DD. primero escribe el cambio en el registro de transacciones. Cuando se complete la transacción, se marcará como confirmada en el registro de transacciones. Esto no significa que los datos se muevan desde el registro de transacciones al fichero de datos. Una transacción confirmada sólo significa que todos los elementos de la transacción se han completado satisfactoriamente. El caché de buffer se puede actualizar, pero no necesariamente el fichero de datos. Periódicamente se realiza un punto de control. Esto le indica a SQL Server que se asegure de que todas las transacciones realizadas son escritas en el fichero de datos apropiado.
Los puntos de control pueden realizarse por estos motivos:
  • Alguien lanza un comando Checkpoint.
  • Se alcanza el intervalo de recuperación configurado en la instancia (ver imagen). Esto indica con qué frecuencia se producen los puntos de control.
  • Se realiza una copia de seguridad de la BBDD (en modo de recuperación simple).
  • La estructura de archivos de BB.DD. se ve alterada (en modo de recuperación simple).
  • El motor de la BB.DD. se ha detenido.


El proceso de escritura de datos a disco se realiza de forma automática, como se indica en el siguiente esquema:


No se escribe directamente a un fichero .mdf o .ndf. Todos los datos primero van al registro de transacciones (.ldf), siguiendo los pasos siguientes:
  1. Se ejecuta algún tipo de comando INSERT, UPDATE o DELETE.
  2. Los datos se escriben inmediatamente a la caché de log interna.
  3. El caché de log actualiza el fichero de log físico (.ldf) y realiza cambios en el buffer caché de datos.
  4. El buffer caché de datos se limpia eventualmente y el fichero de datos (.mdf o .ndf) se actualiza.
Cuando se realiza un backup de la BBDD, sólo los datos actuales y los ficheros del registro de transacciones se escriben a disco. Las transacciones realizadas que aún no se han escrito a disco permanecerán en el log de transacciones y se actualizan durante el proceso de recuperación mientras la BBDD se vuelve a conectar. Las transacciones incompletas se revierten durante la recuperación.

En el siguiente artículo veremos los modos de recuperación de SQL Server.